BROWNFIELD ENGINEERING
Evolución y diagnóstico de sistemas en producción
Mantenimiento brownfield basado en comprender el comportamiento existente antes de modificarlo.
Contexto y problema
Una parte importante de mi trabajo profesional ocurre sobre sistemas que ya existen. Son aplicaciones que tienen usuarios, datos acumulados y comportamientos construidos durante años. Una tarea aparentemente pequeña puede requerir entender código ajeno, reconstruir dependencias y determinar qué supuestos siguen siendo válidos bajo versiones más nuevas del runtime o de la base de datos.
Es una experiencia transversal en distintos sistemas existentes y procesos de actualización hacia PHP 8 y versiones posteriores. El objetivo concreto es mantenerlos operativos, corregir un comportamiento, hacerlos compatibles con un entorno más nuevo o incorporar un cambio sin romper aquello que ya funciona.
Mi responsabilidad y restricciones
Mi responsabilidad es analizar problemas reportados, localizar su origen, reproducirlos cuando es posible, implementar cambios y validar posteriormente que el sistema conserva el comportamiento esperado. Trabajo sobre implementaciones existentes; esto no implica haber desarrollado el sistema original.
Existen datos reales, dependencias, convenciones históricas y otras partes que pueden depender de comportamientos inicialmente no evidentes. Por eso evito modificaciones amplias antes de comprender el problema concreto.
Método de investigación
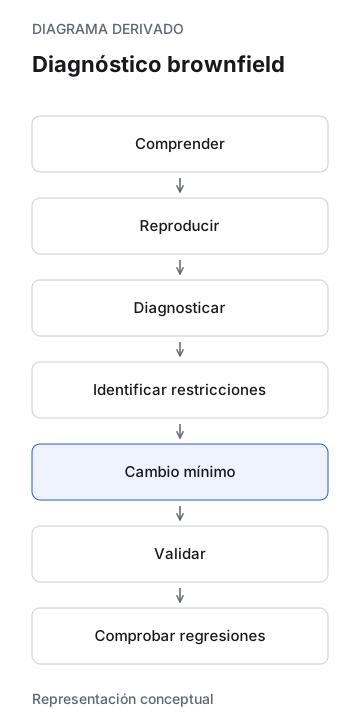
El recorrido es comprender → reproducir → diagnosticar → identificar restricciones → modificar → validar regresiones. Primero busco entender el comportamiento existente y reproducir el problema cuando es posible. El diagnóstico permite reconocer los supuestos y las restricciones antes de decidir qué modificar.
La intervención debe ser proporcional al problema. Después del cambio, vuelvo sobre el flujo afectado y reviso los efectos colaterales relevantes: corregir el error inicial no alcanza si se altera otro comportamiento del sistema.
Microcaso: inserción con AUTO_INCREMENT
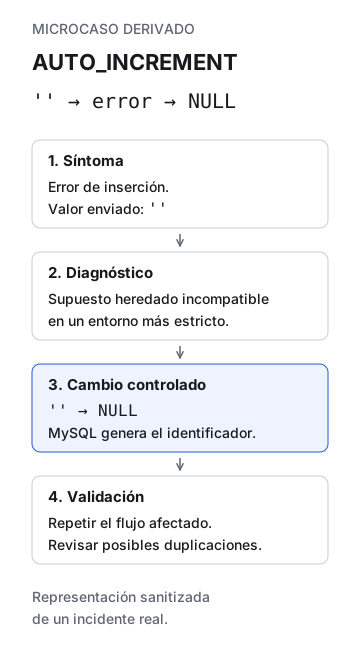
Una operación legacy insertaba registros cuyo identificador utilizaba AUTO_INCREMENT. El helper compartido enviaba una cadena vacía ('') para ese campo entero. El entorno anterior había aceptado ese valor; tras una actualización con runtime y configuración de base de datos más estrictos, comenzó a producir el error Incorrect integer value: ''.
El diagnóstico ubicó el problema en un supuesto histórico dentro de una capa compartida, no en toda la funcionalidad del alta. El cambio fue deliberadamente pequeño: el helper pasó a enviar NULL en lugar de '' cuando la base debía generar automáticamente el campo, delegando esa generación a MySQL.
Después volví a ejecutar el flujo afectado y revisé la posibilidad de inserciones duplicadas u otros efectos secundarios.
'' → error → NULL y de la validación posterior.Resultado y validación
El cambio eliminó el error de inserción y permitió que el flujo volviera a funcionar bajo el entorno actualizado. La validación posterior incluyó el comportamiento que había fallado y la revisión de efectos colaterales relevantes, como posibles registros duplicados.
El alcance de esta validación es el flujo afectado y sus posibles regresiones relevantes, no una garantía general sobre todos los comportamientos del sistema.
Qué demuestra
- Leer código ajeno y reconstruir supuestos heredados antes de intervenir.
- Diagnosticar problemas de compatibilidad entre el comportamiento existente y un entorno actualizado.
- Elegir una intervención proporcional: un cambio pequeño respaldado por un análisis preciso.
- Validar el flujo corregido y revisar posibles regresiones, en lugar de detenerse cuando desaparece el error inicial.
El criterio central es diagnosticar correctamente antes de escribir código.
Tecnología y evidencia
Tecnología y prácticas: PHP / PHP 8+ · SQL · bases relacionales · debugging · migraciones · análisis de código existente · validación de regresiones.
El relato se apoya en respaldo profesional privado de sistemas, código de mantenimiento, fixes y validaciones durante actualizaciones. El diagrama público es un derivado conceptual del proceso de diagnóstico, no una reproducción de un sistema concreto.
Nota de privacidad
PRIVATE PRODUCTION SYSTEM
Los nombres internos, datos, código y configuraciones no se publican. El ejemplo está reducido a su comportamiento técnico esencial, sin exponer detalles de los sistemas privados ni enlazar recursos institucionales.